

(KPMGジャパン作成)
AI for Scienceは、AI技術を科学研究のあらゆる段階に適用し、研究を高度化・高効率化する取組みである。近年の基盤モデルや自己教師あり学習の進展により、これまでデータ解析の補助役として扱われてきたAIが、仮説生成・実験設計・シミュレーション・解析・知識統合といった研究の中核プロセスに入り込み、発見の速度と質を変え始めている。この変化は科学研究の生産性に留まらず、創薬や材料開発などの産業のR&Dを起点に、ビジネスへも波及していくことが予想される。
本記事では、AI for Scienceの近年の進展やそのビジネスへの波及について、生命科学・材料・地球科学などの分野ごとの具体例に触れ、ブレークスルーに焦点を当てながら解説する。さらに、研究開発の競争軸がどのように変化し、企業や組織が今後どのように備えるべきかについても考察する。
なお、本稿に記載されている見解および意見は、あくまで執筆者の私見である。
1. AI for Scienceとは
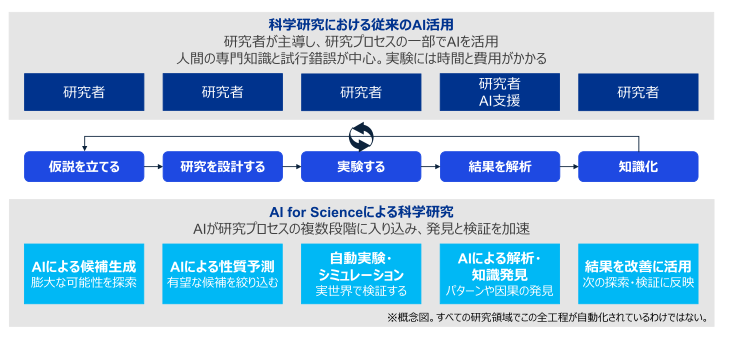
文部科学省の整理では、AI for Scienceは「AI技術を科学研究のあらゆる段階に適用し、さまざまな分野で活用する取組」であり、AIが研究を高度化・高効率化すること、さらにAIが科学研究を自律的に駆動することまでを含むとされる [1]。 ここでいう「研究のあらゆる段階」とは、典型的には「仮説→設計→実験→解析→知識化」という一連のサイクルであり、AIがこのサイクルのどこか一点ではなく、複数点に同時に入り込むことが特徴となる。
従来のAI活用は、分類・予測・最適化などを通じて意思決定を支援してきたが、その多くはすでに定義された問題設定の範囲内における判断の高度化にとどまっていた。一方、AI for Scienceでは、①生成(仮説や候補の提案)、②予測(高価な実験の代替)、③自動化(実験計画と実行のループ)といった機能が統合されることで、探索空間の設定や研究戦略の選択といった上位の意思決定にも影響を及ぼしつつある。
図表1 従来の科学研究とAI for Scienceによる科学研究の比較
2. 科学研究への影響
2.1 分野固有データ基盤と実験自動化が科学研究の回転数を変える
科学分野でAIを使う試み自体は新しいものではないが、近年は「大量の未ラベルデータから表現を学ぶ」自己教師あり学習や、複数モダリティを統合して扱う基盤モデルの普及により、分野固有のデータにも横断的に効く共通基盤が整ってきた。こうした基盤の上に、実験自動化などの技術が重なり、研究の回転数を上げる取組みが実現しつつあるといえる。例えば生命科学では、膨大なタンパク質配列データで事前学習した基盤モデルが、新たなタンパク質や酵素の設計にも活用され始めている。
2.2 分野ごとの影響
生命科学・創薬:象徴的な事例として、タンパク質の立体構造予測を大きく前進させたAlphaFold2が挙げられる。AlphaFold2の公開とデータベース提供 [2] により、研究者は膨大なタンパク質構造の予測結果にアクセスできるようになり、研究の起点(どのタンパク質を対象に仮説を立て、どこから検証を始めるか)が変わった [3]。実験を完全に置き換えるというより、予測構造を足場にして実験計画や解釈を加速し、探索対象を広げる形で効いているという見方も報告されている [4]。従来は研究者が膨大な時間と試行錯誤を経て有望なタンパク質候補を選択していたのが、AlphaFold2により大量の候補を事前に絞り込めるようになり、その結果、探索から実験検証までのサイクルをより短期間で回せるようになった。自然界に存在している物質のうち役に立つものを探索・改良する研究から、必要な機能を先に定義しそれを実現する分子を設計する研究への転換が起きており、医薬品に限らず、目的に合った分子を設計する競争が加熱する可能性がある。
材料・化学:材料開発では、候補を試作して評価するまでのコストが高く、探索空間も広大である。ここでは、「特定の組成・構造ではどのような性質になるのか予測する」物性予測モデルで候補をふるいにかけるだけでなく、「狙った性質を満たす組成・構造を生成する」逆設計(inverse design)が重要になる [5]。生成モデルや最適化とシミュレーションを組み合わせ、計算・実験のボトルネックを越えて候補探索を前に進める発想が広がっている。従来は膨大な候補を順に評価していたが、AIにより狙った特性から候補を逆算するアプローチが現実になりつつあり、実際に試作・検証する候補数の削減が期待できる。企業が材料開発で蓄積してきた実験データ、製造ノウハウ、品質管理能力がAIと組み合わさることで、重要な競争資産になる可能性がある。
地球科学・気候科学:観測衛星データや気候・気象シミュレーションの計算結果が急増する [6] 一方で、解析・同化・品質管理などの工程が研究のボトルネックになりやすい。地球観測のような巨大データ領域で学習された基盤モデルが、データ整備から解析、下流タスクへの適用までを加速する可能性を秘めていることが示唆されている [7]。従来は気象状況の変化を物理方程式で表しスーパーコンピュータで解いていたところを、学習済みAIが従来手法より少ない計算量で実行できるようになり、予測やシミュレーションをより頻繁に実施できるようになった。国外では社会的に重要な気象予測業務にAIベースの予測システムが組み込まれている事例がある [8]。気象予測の精度改善は、企業のリスク管理、設備運用、サプライチェーン、資産配分などの意思決定に直接影響し、意思決定の質を変えることが期待される。
2.3 ブレークスルー:AIが科学研究のボトルネックを解消できるようになった理由
なぜ今、AIは科学研究に影響を及ぼすようになったのだろうか。AI側、科学側にそれぞれ理由があると考えられる。
AI側の要因:データを理解し仮説生成・実験設計まで担うAI
AI技術の進展により、ラベルを使わずに学習を行う方法(例:自己教師あり学習)の高度化が進み、ラベル付けされたデータに依存せずとも、データ内の潜在的な構造やパターンを抽出できるようになった。その結果、限られたラベル付きデータ環境下においても高精度な予測が可能となっている。
さらに近年では、生成AIやエージェントの発展により、AIは単なる予測ツールに留まらず、文献検索やアイデア創出を行える水準に達しており、仮説生成や実験設計などの研究開発プロセスの一部を担う存在へと進化している。
科学研究側の要因:研究データの爆発的増加と意思決定のボトルネック化
データ取得の高頻度化、計算機シミュレーションの大規模化、実験自動化などにより、科学データのハイスループット化が起こった。その結果、ボトルネックは、データの取得から大規模データの扱いや次に行う実験の意思決定へと移り、AIが介入できる余地が増えた。
3. ビジネスへの影響
3.1 発見力から探索・検証速度の競争へ:AI時代に重要になる人材と体制
ここまで科学への影響について述べたが、これらの影響はビジネスへも波及している。これは、主に科学技術に基づいた産業において、研究サイクルの速度の差がAIによってこれまで以上に競争優位へ直結しやすくなるためだ。R&Dは「探索」と「検証」の連鎖で成り立っており、AIは探索空間を広げると同時に検証コストを引き下げる。これにより企業は、より多くの仮説を、より短い時間で試せるようになる。結果として、研究開発の競争軸は「偶然の発見」への依存から、「仮説生成から検証までのサイクルをどれだけ高速かつ再現可能に運用できるか」へ移る。この変化は、研究プロセスの標準化・自動化・プラットフォーム化を加速させ、データ基盤、実験設備、計算基盤、そして研究領域を理解するドメイン専門家とAI・データやソフトウェアを扱う技術者の連携体制が競争力の源泉になっていく。
AIにより探索や検証の多くが自動化され、自律的な研究サイクルを構築する取組みも始まっている。しかし、どの研究課題に資源を投下するか、どの結果を事業や製品開発につながる有望な成果と見なすかといった判断は依然として重要であり、そのためドメイン専門家と技術者の連携が鍵となる。
なお、AI for Scienceの影響は、創薬や材料開発の領域にとどまらない。探索・検証サイクルの高速化は、自動車や半導体などのR&D集約型産業にも広がりつつあり、企業は研究開発の進め方そのものを見直す局面を迎えている。
3.2 ブレークスルー:なぜ今、ビジネスに影響を及ぼすようになったのか
これらの影響が大きくなったのは、なぜ今なのか。その背景には、AI活用を支える技術や基盤の成熟による参入障壁の低下と、AIへの期待を背景とした投資の拡大がある。
ビジネス側でインパクトが見え始めた背景には、いくつかの要素がある。
- 第1に、基盤モデルや関連ツールチェーンが成熟し、個社がゼロから研究開発を始めなくても一定水準のAIを活用できるようになったこと。
- 第2に、クラウドやGPUを中心とした高性能計算基盤の普及により、高性能計算資源を必要なときに必要な分だけ利用できる環境が整備され、スタートアップなどの小規模組織でも参入可能となったこと。
- 第3に、特にバイオ・創薬・化学・材料のような分野ではもともと研究開発の生産性向上への経営的要請が強く(バイオ・創薬については [9], 化学・材料については [10] を参照)、「探索→検証」の回転数を上げる手段としてAI for Scienceが投資対象になりやすくなったこと。
これらの要素を発端に、科学のプロセスを加速させてきたAI for Scienceがビジネスにも影響するようになったのである。
4. まとめ:組織は今後にどう備えるべきか
AI for Scienceを流行語で終わらせず、自社・自組織の競争力の向上につなげるためには、AIモデルやAIツール単体ではなく、研究者、実験・計算環境、科学データを連携させ、それらのセットとして設計する必要がある。具体的には、次の3点が重要になる。
- 研究者・ドメイン専門家と技術者(AI・データ・ソフトウェア)の連携を強め、仮説設定から検証までを分断なくワンストップで回せる体制を作る。
- 科学データを「分析可能(AI-ready)」な形で整備し、取得・前処理・管理・共有に投資する。
- 再現性・妥当性の担保、監査可能性、セキュリティを含むガバナンスを強化し、AIの適用範囲と責任分界を明確にする。
なかでも、研究者と技術者を連携させる体制の構築は、多くの組織にとって特に難易度が高い課題の1つである。必要な人材を自組織だけで確保することは必ずしも容易ではないため、初期段階では大学やスタートアップ、外部パートナーとの連携によって不足する人材を補い、その後、競争優位の源泉となる領域から段階的に内製化を進めていくアプローチが現実的である。
AI for Scienceによる価値創出の差は、AIモデルの性能そのものよりも、データ・実験環境・ガバナンスを含めた研究基盤を整備できるかどうかによって大きく左右される。研究データが分断され、実験条件や測定方法が標準化されていない場合、AIは期待した成果を発揮できない。今後は、優れたアルゴリズムだけでなく、それを継続的かつ組織的に活用できる研究基盤を構築した企業が優位に立つ可能性が高い。
生成AI、エージェントシステム、自律型ラボといった技術の進展は、研究開発だけでなく、事業の設計や投資判断の前提を更新しつつある。今後は、どの研究領域で「探索→検証」のボトルネックが大きいのか、どのデータと設備を起点に閉ループ化できるのかを見極めることが重要な最初のステップになる。その上で、小規模なPoCによる効果検証から始め、外部リソースの活用による人材獲得、デジタル実験環境の構築、実験設備との連携、自律的な探索・検証プロセスの構築へと段階的に実装していくことが現実的なロードマップになる。
参考資料
[1] AI for Science の推進に向けた 基本的な戦略方針の方向性について、文部科学省 資料3-3 科学技術・学術審議会 情報委員会(第45回) 令和8年1月14日
[2] AlphaFold Protein Structure Database
[3] AlphaFold: Research accelerator and hypothesis generator
[4] Terwilliger, T.C., Liebschner, D., Croll, T.I. et al. AlphaFold predictions are valuable hypotheses and accelerate but do not replace experimental structure determination. Nat Methods 21, 110–116 (2024).
[5] Benjamin Sanchez-Lengeling, Alán Aspuru-Guzik, Inverse molecular design using machine learning: Generative models for matter engineering. Science 361, 360-365(2018). DOI:10.1126/science.aat2663
[6] Karianne J. Bergen et al., Machine learning for data-driven discovery in solid Earth geoscience. Science 363, eaau0323(2019). DOI:10.1126/science.aau0323
[7] NASA and IBM Openly Release Geospatial AI Foundation Model for NASA Earth Observation Data
[8] AIFS Machine Learning data | ECMWF
[9] Scannell, J., Blanckley, A., Boldon, H. et al. Diagnosing the decline in pharmaceutical R&D efficiency. Nat Rev Drug Discov 11, 191–200 (2012).
[10] Juan-Pablo Correa-Baena, Kedar Hippalgaonkar, Jeroen van Duren, Shaffiq Jaffer, Vijay R. Chandrasekhar, Vladan Stevanovic, Cyrus Wadia, Supratik Guha, Tonio Buonassisi, Accelerating Materials Development via Automation, Machine Learning, and High-Performance Computing, Joule, Volume 2, Issue 8, 2018, Pages 1410-1420, ISSN 2542-4351.
監修
KPMGアドバイザリーホールディングス
アドバイザリーライトハウス
アドバンスドアナリティクス&AIラボ テクノロジーシニアマネジャー
小澤 友美
執筆
KPMGアドバイザリーホールディングス
アドバイザリーライトハウス
アドバンスドアナリティクス&AIラボ シニアテクノロジスト
細田 至温


