

出所:KPMG作成
予測モデルは「次に何が起こりそうか」を捉える一方、経営の意思決定では「ある施策を実行したら、実行しなかった場合と比べて結果はどう変わるか」が問われます。この差を考えることが、因果分析の出発点です。本稿では、因果探索と因果推論を実務の意思決定に活かす考え方とプロセスを示し、その背景にある技術と前提・限界を解説します。
予測だけでは答えられない経営判断
需要予測、解約予測、不正検知など、機械学習による予測は多くの業務で高度化しています。しかし、予測精度が高いことと、施策の効果を正しく評価できることは同じではありません。
例えば、ある施策に接触した顧客ほど購買率が高くても、その施策によって購買が増えたとは限りません。もともと購買意欲の高い顧客が対象に選ばれていた可能性があるためです。観測された購買率の差には、施策そのものの効果だけでなく、施策対象となる顧客の違いも含まれます。
価格改定、営業施策、設備投資、組織改革など、経営ではさまざまな施策が実行されます。そこで知りたいのは、将来を予測することだけではなく、「その施策が結果をどの程度変えたのか」です。この違いを見誤れば、効果の乏しい施策に投資したり、逆に有効な施策を過小評価したりすることになります。
因果分析は「施策を行った場合と行わなかった場合で結果がどう変わるか」を扱う枠組みです。企業の施策評価だけでなく、政策や公共施策の効果検証にも用いられます。最も直接的な方法は、ランダム化比較試験ですが、実務では費用、期間、倫理、制度上の制約などから常に実験できるとは限りません。そこで、観測データから因果構造の候補を探る因果探索(Causal Discovery)と、想定した因果構造や仮定のもとで介入効果を評価する因果推論(Causal Inference)が重要になります。1, 2
なぜ因果分析は難しいのか
因果分析では、変数を増やし、高度な手法を使えば正しい効果を推定できるとは限りません。どの変数を考慮するかは想定する因果構造と知りたい効果によって変わります。
因果構造をどう捉えるか
因果関係は、変数をノード、変数間の直接的な因果関係を矢印で表す因果グラフとして記述できます。代表的な表現方法が有向非巡回グラフ(Directed Acyclic Graph:DAG)です。DAGを用いることで、想定した因果構造と求めたい効果のもとで調整すべき変数と調整するとバイアスを生む変数を整理できます。図表1に、基本となる3つの構造を示します。
図表1:因果グラフで区別すべき3つの基本構造
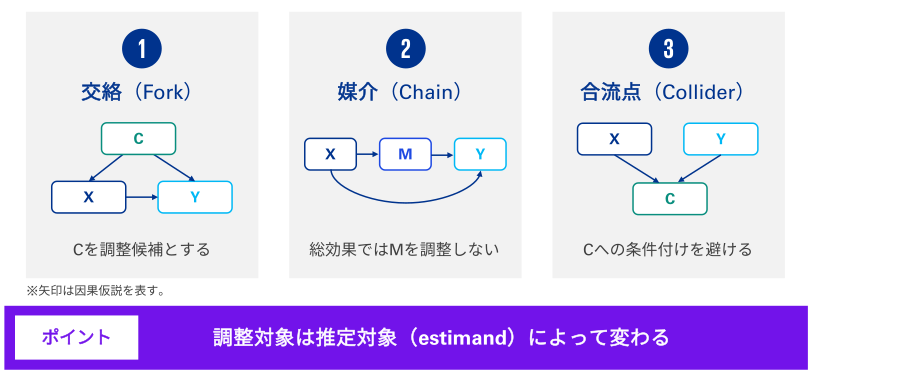
- 交絡:CがXとYの共通原因である場合、XとYの関連にはCによって生じた関連が含まれます。適切な条件の下でCを調整します。
- 媒介:Xの効果がMを経由してYに伝わる場合、Mは媒介変数です。総効果を求めるときにMを調整すると、間接効果を遮断します。
- 合流点:XとYがともにCの原因である場合、Cで条件付けると、本来なかった関連が生じることがあります。
結果と関連しそうな変数を多く加えればよいわけではなく、どの変数を調整するかは、知りたい因果効果と想定する構造から決めます。また、異なる構造が同じ統計的関係を示す場合もあるため、因果探索の出力を確定的な因果関係とはみなさず、時間順序や業務知識、介入データなどを用いて検証します。
仮想例:施策の総効果
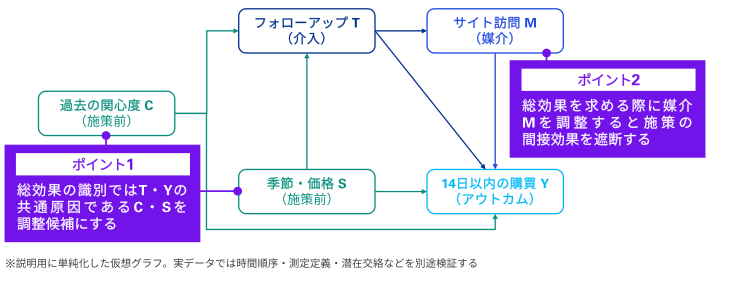
因果構造によって調整すべき変数がどう変わるか、フォローアップ施策の仮想例で確認します。図表2は、フォローアップ施策Tが14日以内の購買Yに与える総効果を示す、単純化した仮想例です。実在するクライアントや分析結果を表すものではありません。
図表2:仮想例――フォローアップ施策が購買へ与える総効果
出所:KPMG作成
過去の関心度Cが高い顧客ほどフォローアップ対象になりやすく、購買もしやすいとします。季節・価格要因Sも施策の割付と購買へ影響するとします。このときCとSは施策と購買の双方に影響するため、施策の効果を評価する際の調整候補となります。
一方、サイト訪問Mが施策後に増え、それが購買へつながるなら、Mは媒介変数です。施策の総効果を求める際にMを調整すると、T → M → Y の経路を遮断し、間接効果を除いてしまいます。CとSが施策前に測定されているか、フォローアップ施策を受けた顧客(処置群)と受けていない顧客(対照群)の双方が存在し、比較可能か、施策対象者の選定に影響する重要な要因が他にないかを確認します。
因果グラフは結果を表示するだけの図ではありません。何の効果を評価したいのか、どのデータが必要なのか、どの変数を調整すべきか、どこを追加で検証すべきかをチームで共有するための設計図として機能します。
実務で起こりやすい誤り
因果構造を見落とすと、もっともらしい分析結果を得ながら、推定したい効果を誤って評価することがあります。典型的なのは次の3つです。
- 関連の強い変数をすべて加える: 結果との関連が強いという理由だけで変数を加えると、媒介変数や合流点まで調整し、推定したい効果を歪める可能性があります。
- 施策後のデータを調整する: フォローアップ後のサイト訪問のように、施策によって変化した変数を調整すると、施策による効果の一部を取り除いてしまう場合があります。
- アルゴリズムの出力をそのまま因果関係とみなす: 因果探索で得られた関係には、データだけでは向きを一意に決められないものもあります。時間順序や業務知識などと照らして検証します。
いずれも、アルゴリズムの性能だけでは防げない問題です。
KPMGが考える因果分析の実務アプローチ
KPMGでは、問いの設定からデータの生成過程、因果構造の仮説、効果の推定、結果の検証までを一連のプロセスとして捉え、因果探索・因果推論に業務知識や追加検証を組み合わせながら分析を進めることを重視しています。
実務ワークフロー
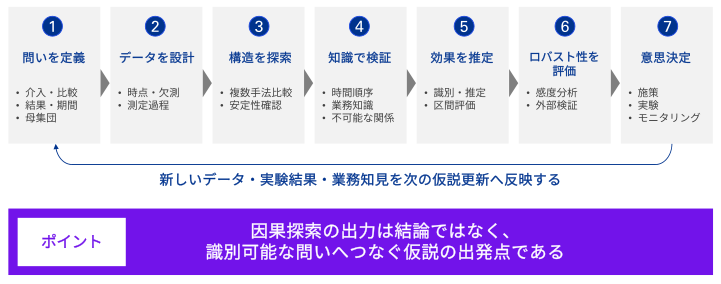
図表3に、実務へ適用するプロセスを示します。各工程を反復しながら分析を進めます。
図表3:因果分析の実務ワークフロー
出所:KPMG作成
「売上の要因は何か」ではなく、「対象顧客へフォローアップした場合、14日以内の購買確率はどの程度変わるか」のように、施策、比較対象、対象者、結果、評価期間を具体化します。続いて、測定時点、取得条件、欠測理由を確認し、データの生成・取得過程を検討します。
因果構造の探索では、異なる仮定を持つ複数の手法を比較し、結果の安定性を確認します。さらに、時間順序や業務プロセスと矛盾する関係がないかを業務知識と照らして検証し、推定したい因果効果と分析で考慮する変数を定めます。
効果推定では、推定値だけを見るのではなく、分析の前提が満たされているかを確認します。必要に応じて感度分析や追加検証を行い、異なる仮定や条件のもとでも結論が大きく変わらないかを検証します。可能であれば小規模な実験や段階導入につなげ、そこで得られた新たなデータや知見を次の仮説に反映します。
業務知識を組み合わせる必要性
データだけで決められないことが残ります。例えば、示された因果関係が時間順序や業務プロセス上成立するか、データがどのような条件で生成・取得されたか、結果をどの意思決定に用いるかは、対象業務を理解しなければ判断できません。
因果分析では、分析手法や統計的前提に関する専門知識と、業務・業界の知見を組み合わせて仮説や結果を検証することが求められます。技術的前提や限界を理解しながら業務知識と照らして結果を解釈し、実務上考えにくい関係を見直し、追加検証すべきデータや仮説を特定することで、分析結果を意思決定につなげます。
KPMGでは、こうした技術的専門性と業務・業界知見を組み合わせながら、分析結果を実際の意思決定につなげることを重視しています。
因果分析の主要技術――因果探索と因果推論
各手法は置く仮定や扱えるデータによって異なります。ここでは、図表3の実務ワークフローにおける「3: 構造を探索」「5: 効果を推定」に対応する主要技術について、実務で理解しておくべきポイントを整理します。
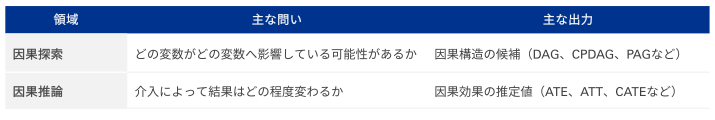
因果分析の全体像
図表4:因果分析の全体像
出所:KPMG作成
因果探索:因果構造の候補を見つける
因果探索は、観測データに含まれる変数間の関係から、因果構造の候補を探索するアプローチです。ただし、観測データだけから因果関係を自動的に確定するものではありません。
因果探索には仮定が必要
因果構造を探索するには一定の仮定が不可欠です。どの仮定を置くかは手法によって異なり、未観測の共通原因や変数間の関係の形、時系列の特性などについて前提が置かれる場合があります。実務では、こうした前提がデータの生成過程や業務知識と整合するかを確認した上で、手法を選択します。
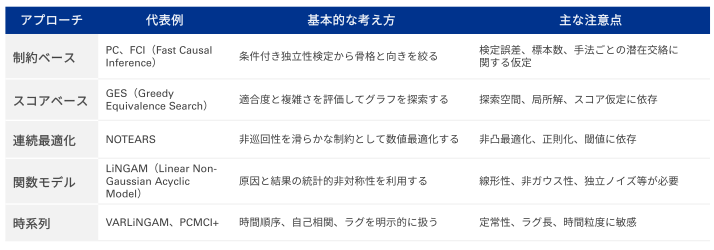
代表的なアルゴリズム
図表5:代表的なアルゴリズム
出所:KPMG作成
各手法は、利用する情報と必要な仮定が異なり、一律に優れた手法があるわけではありません。2-8 実務では、手法の性能指標だけでなく、データ生成過程や業務上成立する仮定を踏まえて選択します。
因果探索の結果をどう解釈するか
因果探索によって、すべての因果関係の向きが一意に定まるとは限りません。例えば、PCやGESは、観測データと仮定のもとで区別できないDAGの集合をCPDAG(Completed Partially Directed Acyclic Graph)として返すことがあります。3, 4 向きが一意に定まらないことはアルゴリズムの失敗ではなく、利用したデータと仮定だけでは因果関係の方向を一意に特定できないことを示します。時間順序や介入データ、非ガウス性などの追加情報や仮定によって、向きの候補をさらに絞り込めます。
因果推論:介入による効果を評価する
因果推論では、観測された関係と実際に介入した場合の効果を区別します。数理的には観測データにおける条件付き確率分布P(Y | X = x) と、Xを外部から操作した場合の介入時の確率分布P(Y | do(X = x))の違いとして表され、両者は一般には一致しません。
何の効果を知りたいのか
分析手法を選ぶ前に「誰に対する、どの介入の、何の効果を知りたいのか」を明確にします。これを推定対象(estimand)と呼びます。例えば、対象者全体の平均処置効果(Average Treatment Effect:ATE)、処置を受けた者に対する平均処置効果(ATE on the Treated:ATT)、属性ごとの条件付き平均処置効果(Conditional ATE:CATE)では、意思決定上の意味も必要な仮定も異なります。10
その効果をデータから識別できるか
次に、求める因果効果を、置いた仮定のもとで観測データから求められる形に表現できるかを検討します。これを識別と呼びます。識別した関係を実際のデータから数値として求めることを推定と呼びます。この順序は重要です。識別できなければ、推定に高度な機械学習を用いても、因果効果を正しく推定できるとは限りません。
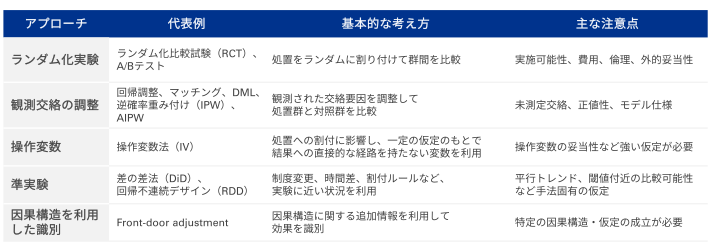
因果効果を識別・推定する代表的なアプローチ
図表6:代表的なアプローチ
出所:KPMG作成
利用できる方法は、データの取得方法と仮定によって異なります。10 Double/Debiased Machine Learning(DML)など、機械学習を組み合わせた推定手法も利用されていますが、正値性や未測定交絡など、因果効果を推定するための前提そのものが自動的に解消されるわけではありません。9, 10
比較できる相手がいるか
観測データから施策の効果を評価するには、施策を受けた対象と受けなかった対象を比較できる必要があります。例えば、購買意欲がきわめて高い顧客には必ず施策を実施している場合、その顧客について「施策を実施しなかった場合」の情報がありません。各条件のもとで施策の有無の双方が起こり得ることを正値性と呼び、処置群と対照群の特性の重なり(オーバーラップ)を確認します。
重要な違いを測れているか
もう1つ重要なのは、施策の対象となりやすさと結果の双方に影響する要因がデータに含まれているかです。例えば、もともと購買意欲の高い顧客ほどフォローアップ施策の対象になりやすく、施策がなくても購買しやすいとします。「購買意欲」が測定されていなければ、観測された購買率の差が、施策によるものなのか、もともとの顧客特性によるものなのかを十分に区別することが難しくなります。これが未測定交絡の問題です。
KPMGは分析結果の妥当性をどう検証するのか
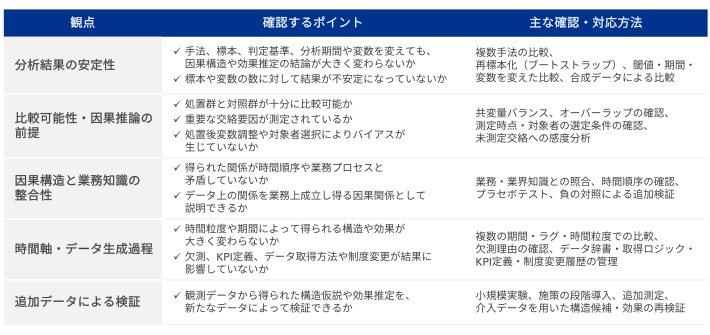
複数の手法で同じ関係が得られることは、結果の安定性を判断する上で有用です。ただし、それだけで因果関係が保証されるわけではありません。複数の手法が、共通の仮定や同じデータ品質上の問題の影響を受けることがあるためです。異なる条件で結果が安定しているか、分析の前提が満たされているか、業務知識と整合するかも確認します。既存データだけで判断できない場合は、追加測定や小規模実験、段階導入で検証します。図表7に、検証の主な観点と実務上の留意点を整理します。
図表7:因果分析の妥当性を検証する主な観点
出所:KPMG作成
今後の展望
観測データだけでは因果構造を一意に定めにくく、未測定交絡が存在する場合は、その特定がさらに難しくなります。こうした課題に対し、観測データに複数の介入データを加えることで、因果構造の候補をどこまで絞り込めるか理論化する研究 11や、未測定交絡を許容する特定のモデルクラスにおいて、観測データの特徴を利用して因果構造を特定する方法の研究が進んでいます。12
一方で、技術の高度化や自動化が進んでも、何を介入と捉え、何をいつ測定し、結果をどの意思決定に用いるかは、業務・業界の理解なしには決まりません。今後も、技術の進歩と業務知識を組み合わせながら、分析可能な問いを設計し、その結果を意思決定へと活かすことが、因果分析の実務では重要になります。
KPMG/アドバイザリーライトハウスの取組み
KPMGジャパンは、因果探索と因果推論を統合した分析ツールを活用し、因果構造の候補抽出から施策効果の定量評価までを支援しています。公開しているサービスでは、複数の因果探索アルゴリズムとアンサンブル、エッジ強度・手法間合致度の指標化、平均因果効果(ATE)の推計、業務知識を反映するグループ間の方向制約を技術的特徴として掲げています。13
因果分析の実務には、統計・機械学習に加え、データ生成過程を理解し、業務上の制約を検証可能な仮説へ変換する力が問われます。アドバイザリーライトハウスでは、データサイエンスの専門性とKPMGが持つ業務・業界知見を組み合わせ、データ設計、因果構造の探索、効果推定、結果検証までを一貫して検討しています。これにより、分析結果を提示するだけでなく、その前提や不確実性を踏まえながら、実際の施策や意思決定につなげることを目指しています。サービスの詳細は「因果分析ツールを用いたデジタルマーケティング高度化支援」をご参照ください。
まとめ
因果分析は、「相関を因果へ変換するアルゴリズム」ではありません。データ生成過程の仮定を明示し、観測データ、業務知識、統計的証拠、可能な介入を組み合わせて、意思決定に必要な問いへ答えるプロセスです。
因果探索で構造仮説を立て、因果推論で因果効果の識別可能性を検討・推定します。探索結果を確定的な真実とはみなさず、仮定と不確実性を明らかにし、次の検証や実験へつなげることが求められます。
参考資料
1. Pearl, J. (2009). “Causal inference in statistics: An overview.” Statistics Surveys, 3, 96–146.
2.Peters, J., Janzing, D., & Schölkopf, B. (2017). Elements of Causal Inference: Foundations and Learning Algorithms. MIT Press.
3. Kalisch, M., & Bühlmann, P. (2007). “Estimating High-Dimensional Directed Acyclic Graphs with the PC-Algorithm.” Journal of Machine Learning Research, 8, 613–636.
4. Chickering, D. M. (2002). “Optimal Structure Identification With Greedy Search.” Journal of Machine Learning Research, 3, 507–554.
5.Shimizu, S., Hoyer, P. O., Hyvärinen, A., & Kerminen, A. (2006). “A Linear Non-Gaussian Acyclic Model for Causal Discovery.” Journal of Machine Learning Research, 7, 2003–2030.
6. Zheng, X., Aragam, B., Ravikumar, P. K., & Xing, E. P. (2018). “DAGs with NO TEARS: Continuous Optimization for Structure Learning.” Advances in Neural Information Processing Systems 31.
7. Hyvärinen, A., Zhang, K., Shimizu, S., & Hoyer, P. O. (2010). “Estimation of a Structural Vector Autoregression Model Using Non-Gaussianity.” Journal of Machine Learning Research, 11, 1709–1731.
8. Runge, J. (2020). “Discovering contemporaneous and lagged causal relations in autocorrelated nonlinear time series datasets.” Proceedings of Machine Learning Research, 124, 1388–1397.
9. Chernozhukov, V., et al. (2018). “Double/debiased machine learning for treatment and structural parameters.” The Econometrics Journal, 21(1), C1–C68.
10. Hernán, M. A., & Robins, J. M. (2020). “Causal Inference: What if.” Chapman & Hall/CRC.
11. Hauser, A., & Bühlmann, P. (2012). “Characterization and Greedy Learning of Interventional Markov Equivalence Classes of Directed Acyclic Graphs.” Journal of Machine Learning Research, 13, 2409–2464.
12. Wang, Y. S., & Drton, M. (2023). “Causal Discovery with Unobserved Confounding and Non-Gaussian Data.” Journal of Machine Learning Research, 24(271), 1–61.
13. KPMGジャパン(2026)「因果分析ツールを用いたデジタルマーケティング高度化支援」
監修
KPMGアドバイザリーホールディングス
アドバイザリーライトハウス
アドバンスドアナリティクス&AIラボ テクノロジーマネジャー
小澤 友美
執筆
KPMGアドバイザリーホールディングス
アドバイザリーライトハウス
アドバンスドアナリティクス&AIラボ シニアテクノロジスト
Staffini Alessio
KPMGアドバイザリーホールディングス
アドバイザリーライトハウス
アドバンスドアナリティクス&AIラボ マネジャー
土肥 良弥


